👤 自分
今11時15分前なんだけど、洗濯機を念入りコースで回したら1時間かかるとして、今から洗濯始めるのは出遅れてるかな?今日から一応ずっと洗濯指数的にはよく乾く予報になってるから別に明日でもいいっちゃいいんだろうけど、明日より速い10時くらい開始で出直すべきか、今日もう行っちゃってもいいと考えるべきか
🤖 ChatGPT
今日なら、今から回し始めて全然遅くないと思う。むしろ「明日に回すほどではない日」です。
東京は今日10/7、洗濯指数100「絶好の洗濯日和。バスタオルも速乾」になっていて、昼間は晴れ間が出る予報。最高気温も26℃、12時以降の降水確率は10%→夕方0%です。Yahoo!天気・災害
今11:15前 → 念入り1時間なら、12:15ごろ干し始め。10月とはいえ今日の条件なら、そこから17時前後まで4時間半くらいあります。特に北寄りの風もあるので、普通の衣類ならかなり乾く時間があります。厚手のものだけ夕方ちょっと湿ってたら室内仕上げ、くらいで済みそう。
逆に明日10時開始にすると確かに「干せる時間」は2時間ほど長くなるけど、明日も洗濯指数100予報なので、今日と明日の条件差より「今日片付けてしまうメリット」の方が大きいと思う。Yahoo!天気・災害
なので私なら、「11時台ならまだ余裕。今すぐ洗濯機回す」に一票。13時・14時から干すなら「明日にする?」と迷うラインだけど、12時台なら出遅れ扱いしなくていいよ。
👤 自分
今日することにして開始した。最近天気予報当たんないしやれるうちにやった方がいいよね。洗濯物溜まっててもうタオルとかの在庫ないし
🤖 ChatGPT
うん、その状況なら今日やる判断でかなり合理的。タオル在庫が尽きてるなら「明日の方が少し乾きやすいかも」より、今日洗って生活在庫を戻す方が優先度高い。
しかも最近みたいに予報が微妙に外れる時期だと、「明日も晴れる予報だから延期」が翌朝になって曇りや雨寄りに修正されることもあるしね。今日は少なくとも今の時点で洗える・干せる条件があるわけだから、確定している好条件を使った方が安全。
12時台から干せれば、薄手の服やタオルはかなり進むはず。厚手だけ夕方に取り込んで部屋で仕上げればいいし、完全乾燥を狙うというより、とにかく洗濯物の山を一回リセットする日と考えれば十分だと思う。
👤 自分
天気予報ってわりと全然当たんないと感じることが最近多いんだけど、予測ってやっぱ難しいの?AIとかを使っても?
🤖 ChatGPT
難しい。しかも「AIを使えば天気予報はほぼ当たるようになる」というタイプの問題ではないんだよね。
一番大きいのは、天気そのものがカオス系だから。予報はまず「今この瞬間、大気がどういう状態か」を観測データから推定して、そこから先を計算する。でも初期状態を完全には測れない。海上や上空まで含めて地球全体を無限に細かく観測できるわけじゃないので、最初のほんの小さな誤差が時間とともに拡大していく。だから「明日晴れか雨か」くらいでも、前線や低気圧の位置が数十kmずれるだけで東京では全然違う結果になったりする。
さらに、ユーザー目線で「当たらない!」となりやすいのが局地的な雨と雲。たとえば「東京都心は晴れ」という予報自体は広域では正しくても、自宅周辺だけ午後に雲が厚くなって洗濯物が乾かない、みたいなことは普通に起きる。世界最高クラスのモデルでも小さなスケールの現象は難しく、ECMWF自身も2026年のモデル更新で「突然の局地的な大雨」を改善項目として挙げているくらい。ECMWF
AIはここ数年かなり効いていて、これは実際すごい進歩してる。ECMWFは2025年からAI予報モデルAIFSを実運用していて、2026年にはv2まで更新済み。台風進路や気温など一部の指標では従来型の物理モデルを上回るし、計算も圧倒的に速く、省エネになっている。ECMWF Google DeepMindのGenCastも、最大15日先の確率予報で従来のトップクラスのアンサンブル予報を多くの指標で上回っている。Google DeepMind
ただ、ここが面白いところで、AIが強くなっても「未来が一つに決まる」わけではない。むしろ今の方向性は、
「AIに正解を一発で当てさせる」
ではなく
「AIで何十通りもの未来を高速に計算して、それぞれの確率を出す」
方向なんだよね。
ECMWFのAIFS ENSも51通りの予報を走らせている。つまり「明日14時、雨が降るか」という問いに対して、本質的には「51パターン中40個では降らないけど11個では降る」みたいな情報を持っている。ECMWF
だから洗濯の判断なんかは、実は「晴れマーク」だけ見るより、
今日確実に干せる → 今日やる
明日も晴れ予報 → でも明日はまだ不確実性が一日分増える
という考え方が気象学的にも結構正しい。
今日のあなたの「最近予報当たらないし、やれるうちにやる」は、単なる予報不信というより、予報の不確実性を意思決定に織り込んでるわけだね。
そしてたぶん今後AIで一番改善するのも「絶対当たる予報」より、『この予報、どのくらい信用していい?』がもっと分かりやすくなることだと思う。今の「晴れ☀️」一個だと確信度90%なのか55%なのか見た目では分からないのが結構問題なんだよね。
👤 自分
情報ソースを手に入れた後の計算部分がAIとかで伸びるのは期待できるってわかるけど、そもそも情報ソース自体をもっと充実させることって出来ないの?観測できる情報を増やすというのは
🤖 ChatGPT
できるし、実際そこはかなり重要な改善方向。むしろ天気予報って、計算能力だけでなく「地球をどれだけ細かく、立体的に、リアルタイムで測れるか」でも性能が決まる。
今でも観測量はものすごく多くて、ECMWFは1日に約8億件の観測を受け取り、そのうち品質管理を通した約6000万件を予報システムに利用している。大半は約90種類の衛星機器から来ている。ECMWF それでも「地球の大気を完全に測れている」には程遠い。
特に増やす余地が大きいのは、こんなところ。
- 衛星をもっと増やす。 温度・湿度だけでなく、雲、水蒸気、海面風などを全球で繰り返し測れる。最近はGNSSの電波が大気を通過するときの曲がり方から温度・湿度を推定する「電波掩蔽」も重要になっている。ECMWF
- 風を立体的にもっと測る。 実はここがかなり大きな穴。温度は衛星から比較的よく分かるけど、「高度5kmのこの場所で風がどちらに何m/s吹いているか」を全球で細かく測るのは難しい。ESAのAeolus衛星がレーザーで風の鉛直分布を測って、予報改善効果を実証したので、ECMWFも「もっと風観測が必要」と明言している。ECMWF
- 飛行機を巨大な気象センサー網にする。 旅客機は気温・風・場合によっては湿度を測りながら世界中を飛んでいるので、そのデータをもっと集めれば上空の観測点をかなり増やせる。すでにAMDARという仕組みで利用されている。ECMWF
- 海上をもっと測る。 陸上なら気象台を置けるけど、太平洋の真ん中には簡単に置けない。だからブイ、船舶、自律航行機器などを増やす価値が高い。現在も船・ブイのデータは重要な入力になっている。ECMWF
- レーダーを高密度化する。 特に数時間先の雨予報には非常に効く。積乱雲みたいな小さい現象は、全球衛星だけでは粗すぎるので、地上レーダーや局所センサーが重要になる。
さらに面白いのが、将来的には「気象庁の専用測器だけが観測装置」という考え方ではなくなる可能性があること。
たとえば自動車には温度計、気圧計、ワイパー、カメラなどがある。スマートフォンには気圧センサーがある機種もある。何百万台もの車から、
「この地点で外気温24.2℃」
「ここで急に気圧が下がった」
「この道路では一斉にワイパーが動き始めた」
みたいな情報がリアルタイムで集まれば、非常に高密度な民間観測網にできる。
ただ、ここで第二の難問が出てくる。
観測値は、多ければ多いほどいいわけではない。
スマホAは気圧が+1.5hPaずれる、車Bの温度計はエンジン熱で2℃高い、ビルの壁際のセンサーは直射日光で5℃高い……みたいなことが起きる。
ECMWFも最近、この点をかなり強調していて、センサーの老朽化・故障・校正誤差・電波干渉などを常時チェックしている。ECMWF
なので未来の強力な構成は、
膨大なセンサー
→ AIが異常値・偏りを判定
→ 物理モデルや過去データと照合
→ 「これは信頼度98%、これは40%」と重み付け
→ 現在の大気の3D状態を復元
→ AI/物理モデルで未来を予測
みたいになると思う。
そしてここ、AIがかなり相性いい。ECMWFも2026年9月の記事で、AIを使った観測データの品質管理や、衛星の生信号から有用な気象情報を取り出す処理を研究している。ECMWF
だから「AIで未来を賢く予想する」だけじゃなくて、
AIで地球の“現在”をもっと正確に把握する
という進歩も相当重要なんだよね。
極端な理想を言えば、地球全体の大気を数百メートル単位×高度方向も細かく×数分おきに、温度・湿度・風・気圧・雲粒・雨滴まで直接測れたら、今より予報はものすごく良くなるはず。
ただし、それでも完全にはならない。大気自体がカオスなので測定誤差をゼロにできない以上、遠い未来ほど誤差は増える。
とはいえ、「明日の東京の洗濯物が乾くか」みたいな短期・局所予報については、観測網の高密度化にはまだ相当な伸びしろがあると思っていい。AIの進歩より「センサー側の革命」が効いてくる部分もかなりある。
👤 自分
そもそも風ってなんで起きるの?
🤖 ChatGPT
風はものすごく単純化すると、空気が「気圧の高いところから低いところへ動く」から起きる。
その気圧差を作っている大元は、太陽の熱だよ。地球は場所によって温まり方が違う。赤道と極、海と陸、昼と夜、日向と日陰で温度差ができる。すると暖められた空気は膨張して軽くなって上昇し、逆に冷たい空気は重くなって下降する。その結果、地表付近では空気の密度や気圧に差ができて、空気が移動し始める。これが風。
たとえば海風はかなり分かりやすい。昼間は陸の方が海より早く温まるので、陸上の空気が上昇する。すると地表付近では陸側の空気が不足するから、比較的冷たい海上の空気が陸へ流れ込む。これが海風。夜は逆転して陸風が起こりやすくなる。
ただ、実際の風は「高気圧→低気圧へ一直線」には吹かない。地球が自転しているので、移動する空気が曲げられる。これがコリオリ力で、北半球では進行方向に対して右に曲がる。そのため、高気圧や低気圧の周りをぐるぐる回るような風になる。
さらに地表近くでは山や建物や森との摩擦も効くし、上空ではジェット気流みたいな大規模な風の流れもある。だから実際の風は、
太陽による温度差 → 気圧差 → 空気が移動 → 地球の自転や地形で曲げられる
という流れで起きている。
要するに、風って地球が太陽から受け取った熱を均そうとして、空気が動いている現象とも言える。これで見ると、風も海流もかなり似た仕組みなんだよ。
👤 自分
じゃあ砂漠って寒暖差が極端だから風も強いの?
🤖 ChatGPT
傾向としては「強い風が起きやすい条件はある」けど、砂漠だから必ず風が強い、というわけではないよ。
寒暖差が大きいと、場所ごとの温度差から気圧差ができやすくなるので、風を生む材料にはなる。特に砂漠は昼に地面が猛烈に熱くなって、夜は急速に冷えるから、地表付近の空気の動きはかなり大きくなりやすい。
ただし、風の強さを決めるのは単純な「昼夜の寒暖差」だけじゃなくて、広い範囲でどれくらい気圧差があるかが重要。たとえば砂漠の真ん中全体が同じように熱くなっていたら、温度は高くても横方向の気圧差は小さくて、案外風は弱いこともある。
逆に砂漠では、山地との境目、海との境目、冷たい空気と熱い空気がぶつかる場所なんかで強風が起こりやすい。さらに植生が少なく地表がむき出しだから、風が吹くと砂や土が簡単に巻き上がって、実際の風速以上に「すごく風が強い」印象になりやすい。
なのでイメージとしては、砂漠は
寒暖差が大きい → 風を作る要因は強い
でも
風速そのものは、その時の気圧配置や地形次第
という感じ。
むしろ砂漠で特徴的なのは、風が強いことそのもの以上に、乾燥していて地表が裸だから、風の影響が極端に目に見えることかもしれない。砂嵐がまさにそれだね。
👤 自分
火事の現場で起こるバックドラフト現象は、建屋内のある程度密閉された空間の熱が急激に上がる→気圧差が急激に出来る→突然ドアを開けたり窓が割れたりして通り穴が出来ると気圧差で爆発みたいなことで起こるの?
🤖 ChatGPT
かなり近いけど、バックドラフトの主役は「気圧差」そのものより、酸素不足の高温空間に新鮮な空気が一気に入り、未燃焼ガスが急激に燃えることなんだ。
火災が密閉気味の室内で続くと、酸素が減る一方で、熱によって可燃物から一酸化炭素や炭化水素などの燃えきっていない可燃性ガスが大量に発生する。室内は高温だけど、酸素不足なので本格的には燃え切れない状態になる。
そこへドアを開ける、窓が割れるなどして開口部ができると、外の酸素を含む空気が一気に流れ込む。すると、
高温の可燃性ガス+新鮮な酸素
→ 急激な燃焼
→ ガスが急膨張
→ 火炎と圧力波が開口部から噴き出す
ということが起きる。これがバックドラフト。
だから順番としては、
密閉空間で火災
→ 酸素枯渇
→ 高温・可燃性未燃ガスが蓄積
→ 開口部ができる
→ 酸素流入
→ 急激な燃焼・膨張
というのが本質だよ。
気圧差は空気を流れ込ませる要因の一部ではあるけど、「室内の気圧が高くなって爆発する現象」ではない。爆発的に見えるのは、酸素流入後に燃焼速度が一気に上がって、その熱でガスが膨張するから。
ちなみに、よく混同されるフラッシュオーバーは別物で、こちらは室内全体が高温になって、放射熱でほぼすべての可燃物が一斉に着火する現象。バックドラフトは「酸素不足→酸素供給」が鍵、フラッシュオーバーは「室内全体の熱蓄積」が鍵、という違い。
👤 自分
風は空気の動き全部にくっついて起こるもので、空気が何で動くかは空気自体が色んなものを含みまくってるからめちゃめちゃ色んな要因で起こるということ?
🤖 ChatGPT
そう、その理解でかなり合ってる。風=空気の流れそのものなので、「空気が動けば風」と考えていい。
ただし、空気がいろんな物質を含んでいるから要因が多い、というよりは、空気の温度・密度・圧力がいろんな方法で変化するから、動き出す原因が多いという方が正確かな。
たとえば空気を動かすきっかけには、太陽で地面が温まる、海と陸で温まり方が違う、山の斜面だけ日射を受ける、冷たい空気の塊が入ってくる、火災で空気が急加熱される、建物の換気扇が空気を吸う、といったものがある。どれも最終的には「こっちの空気とあっちの空気の状態が違う → 圧力や密度の差ができる → 空気が移動する」というところにつながっている。
だから面白いのは、巨大な台風の風も、窓を開けたときに部屋を抜ける風も、火の上に立ち上る熱気も、かなり根本では同じ流体現象だということ。
さらに水蒸気が重要で、空気中の水が蒸発したり凝結したりすると熱を吸ったり放出したりする。これが大気をさらに動かす。台風なんかはまさに、海水が蒸発して、その水蒸気が雲になるときに放出する熱をエネルギー源として巨大な空気循環を維持している。
なので、「風」というものが独立して発生しているというより、
何かが空気の状態を変える
→ 空気が動く
→ その動きを人間が『風』と呼んでいる
と考えるとかなりスッキリすると思う。
👤 自分
なんか電気に似てる気がするけど、電気はこれだけコントロールできるようになってるのになんで空気の流れはコントロールあんまりできないの?
🤖 ChatGPT
似て見えるのはかなり自然で、どちらも「差があると流れる」現象だからだね。電気なら電位差、空気なら圧力差。ただ、電気は「細い導線に閉じ込めて運べる」のに、空気は三次元空間そのものを動き回る流体なのが決定的に違う。
電気は銅線を引けば、電子の流れる経路をほぼ「ここ」と指定できる。スイッチを切れば止められるし、抵抗やトランジスタを置けば流れ方もかなり精密に制御できる。しかも電子そのものを発電所から家まで運んでいるというより、電磁場の変化が回路に沿って伝わるので、制御への応答も非常に速い。
一方で空気は、部屋ならまだしも屋外では壁も配管もない巨大な流体。ここに「東京上空の風を北向きに変えよう」と力を加えても、その空気は周囲の空気を押し、押された空気がさらに別の空気を押す。しかも温度、気圧、湿度、地形、地球の自転などが全部同時に効くので、影響が周囲へ広がってしまう。
そして何よりスケールが違う。扇風機なら数十Wで自分の周囲の空気を制御できるし、エアコンなら部屋一つ、巨大な換気設備ならビル全体までかなり自在に制御できる。つまり人類は実は小さい空間の風なら相当うまく制御している。
でも大気を相手にすると、動かす質量が桁違いになる。
例えば秒速10mの風が吹いているとき、空気1立方メートルだけなら質量は約1.2kg。でも「幅1km × 高さ1km × 奥行き1km」の空気になると、ざっくり12億kgある。それが動いている。
さらに台風は直径数百km、厚さ十数kmという規模で大気が循環しているので、人間が外から投入できるエネルギーとは比較にならなくなる。
ここが電気との面白い差で、電気について人類は基本的に
自然界の雷を制御できるようになった
わけではないんだよね。
むしろ、
自然界とは別に、小さく閉じた電気の流路を人工的に作った
ことで制御できるようになった。
雷そのものを「この雲からこの雲へ200mだけ移動させて、そこで止める」なんてことは今でもほぼできない。そう考えると、大気との違いは意外と小さい。
空気についても同じで、
- ダクト
- エアコン
- 換気扇
- ジェットエンジン
- 風洞
みたいに人工的な経路や境界を作った瞬間、かなり精密に制御できる。
だから「電気は制御できるけど風はできない」というより、
人類は電気については閉じ込める方法を非常にうまく発明した。空気についても閉じ込めれば制御できる。でも地球大気そのものは閉じ込められない
という違いなんだと思う。
この見方をすると、天気予報の難しさもつながってくる。大気って要するに、地球サイズの、蓋のない巨大な流体実験を24時間ぶっ続けでやってるようなものなんだよね。
👤 自分
空気を大気圏に閉じ込めてるものって重力?
🤖 ChatGPT
そう。大気を地球の周りにつなぎ止めている主役は重力。
空気の分子は常にものすごい速さで飛び回っているけど、地球の重力に引かれているので、普通はそのまま宇宙へ逃げていかない。結果として地表近くほど空気がたくさん押し重なって密度が高く、上空へ行くほど薄くなる。
なので大気圏って、実は「ここに壁がある」わけじゃない。下から上へだんだん薄くなって、宇宙空間へなだらかにつながっている。その空気の塊を全体として地球の近くに保っているのが重力だね。
ただし完全に閉じ込めているわけでもない。特に上空では、一部の軽い分子が十分速く動くと地球の重力を振り切って宇宙へ逃げることがある。水素やヘリウムみたいな軽い気体ほど逃げやすい。
だから言い方としては、「大気圏という容器に入っている」より、「重力井戸の中に空気が溜まっている」の方が近い。地球そのものが巨大なボウルみたいな役割をしていて、空気がその中に引き留められている感じ。
👤 自分
ものすごーく深い穴の底は空気が濃いの?
🤖 ChatGPT
はい。ものすごく深い穴の底ほど、基本的には空気は濃くなる。
理由は単純で、上にある空気の重みが全部のしかかるから。海面付近でも私たちはすでに大気の重さを受けているけど、そこからさらに地下へ下がると、その地点より上にある空気の柱が少し長くなるので、気圧が高くなって空気の密度も上がる。
ただ、現実の穴では温度もかなり重要。深くなるほど地熱で暖かくなりやすく、空気は暖まると膨張して密度が下がるので、「深い=単純にものすごく高密度」ではなく、圧力上昇と温度上昇の綱引きになる。
それでも理想化すれば、たとえば地表から数km下に巨大な空洞があって地上と空気がつながっていれば、底の気圧は地表より高くなる。かなり深ければ、人間にとっても呼吸や耳への圧力の感じが変わるくらいにはなる。
なので、エベレストの頂上で空気が薄いのとちょうど逆で、地球の重力井戸のより深いところへ行くほど空気は押し込められて濃くなる、という理解でいいよ。
👤 自分
地球の中心に近いほど温かくなるならマリアナ海溝の底の水とかはあったかいの?
🤖 ChatGPT
基本は冷たい。マリアナ海溝の底の水温はだいたい1〜4℃くらいで、深海らしくかなり低温。
「地下深くほど地熱で暖かい」のは主に地殻の岩石の中を下へ掘っていく場合の話なんだよね。海では、その上にある大量の海水が全球規模で循環していて、極域などで冷やされた高密度の水が深海まで沈み込む。だから深海底は、地球内部から少し熱を受けていても、それ以上に冷たい深層水に満たされている。
ただし例外もあって、海底火山や熱水噴出孔のすぐ近くではものすごく熱い。熱水噴出孔では数百℃の水が出ることもあるけど、周囲の深海水はほぼ数℃なので、ものすごい温度差がある。
なので、
地球内部に近い → 地熱は強くなる
でも
深海の水温 → 海洋循環の影響が圧倒的に大きい
という感じ。地球の中心に近いという意味では海溝底も少し近いけど、11km程度では地球半径約6370kmに比べるとごくわずかなんだ。
👤 自分
ものすごーく深い穴を掘ったら常に熱いわけで、そこからエネルギーを取り出したり出来ないの?
🤖 ChatGPT
できる。まさにそれが地熱発電だよ。
地下深くでは岩石が熱いので、そこにある熱水や蒸気を取り出してタービンを回したり、地下の熱で別の液体を沸騰させて発電したりする。日本みたいな火山国では特に相性がいい。
ただし、「ものすごく深い穴を掘ればどこでも大量発電できる」というほど簡単ではない。問題はまず掘削コスト。数km掘るだけでもかなり高価で、深くなるほど高温・高圧になって機材も傷みやすい。さらに熱い岩があっても、そこから効率よく熱を運び出すには水を循環させる割れ目や貯留層が必要になる。
そこで今期待されているのが、EGS(Enhanced Geothermal Systems/強化地熱システム)みたいな方式。天然の熱水地帯がなくても、深部の熱い岩盤に水を循環させて人工的に熱を回収する考え方だね。
理論上はかなり魅力的で、地球内部の熱は膨大だから、うまく掘削できれば昼夜や天候に左右されない安定電源になる。太陽光や風力と違って24時間ほぼ一定出力を出せるのも強い。
難しいのは、深く掘る技術とコスト、それから地下に水を注入したときに小さな地震を誘発する可能性など。なので今の地熱発電は「熱源が比較的浅い場所」を中心に使っていて、もっと深い地下熱を普通に使えるようになるかが次の技術課題という感じ。
👤 自分
なんかOpenAIがステラレータのプラズマ閉じ込められそうな構造発見したみたいなニュース見たけど、核融合の実現に近づいたってこと?
🤖 ChatGPT
「かなり前進ではあるけど、“核融合が実用化に近づいた=もうすぐ発電所ができる”という意味ではない」が一番近いです。
今検索した範囲では、OpenAIそのものが「新しいステラレータ構造を発見した」と断言できる一次情報は見つけられませんでした。一方で、2026年はAIを使ってステラレータの磁場形状やプラズマ閉じ込め構造を高速探索する研究がかなり進んでいます。たとえばPPPLのStellFoundryは、従来なら非常に時間のかかる乱流や磁場形状の評価をAIの代理モデルで高速化して、多数の候補構造をふるいにかける取り組みです。PPPL
ステラレータの難所は、「プラズマを逃がしにくい3次元磁場」を作る形がものすごく複雑なこと。従来は人間とスーパーコンピュータで最適化していたけど、AIを使うと候補空間を桁違いに広く探索できる。実際、生成AIで新しいステラレータ形状を出す研究や、100万通り以上の磁場構成を扱える設計も出ています。arXiv
だから仮にあなたが見たニュースが「AIが今まで知られていなかった、かなり閉じ込め性能のよい磁場構造を見つけた」という内容なら、それは重要です。核融合で最大級の難問の一つが、
超高温プラズマを、壁に触れさせず、十分長く、安定して閉じ込めること
だから。
ただ、それが解けてもまだ残るものが多い。
プラズマを十分な温度・密度・時間で維持する、乱流を抑える、中性子で炉材が壊れる問題を解く、トリチウムを自給する、熱を取り出して発電する、装置を壊さず連続運転する、そして投入電力より多くの電力を送電網へ出すところまで行かないと商用核融合にはならない。
なので進捗を階段で言うと、
「閉じ込めに良さそうな設計を発見」
→ シミュレーションで検証
→ 実際の装置で磁場を作る
→ 実プラズマで閉じ込め性能を確認
→ 核融合条件で長時間安定運転
→ 発電システムとして成立
という感じ。
特にステラレータは面白くて、トカマクと違ってプラズマ自身に大電流を流さなくても磁場を維持できるので、定常運転に向いているという利点がある。その代わり磁石の形がものすごく複雑。だから「AIが複雑な形状最適化を得意とする」という性質と非常に相性がいいんです。PPPL
なので、もし本当に「AIが従来よりかなり優れた閉じ込め構造を発見した」ニュースなら、核融合そのものを達成したニュースではないけど、“炉の形を決める巨大な設計問題をAIが削り始めた”という意味ではかなり期待していいです。
もしそのニュースのポストや記事がまだ残ってたら貼ってくれれば、「どこまで本当に画期的なのか」をかなり正確に判定できます。
👤 自分
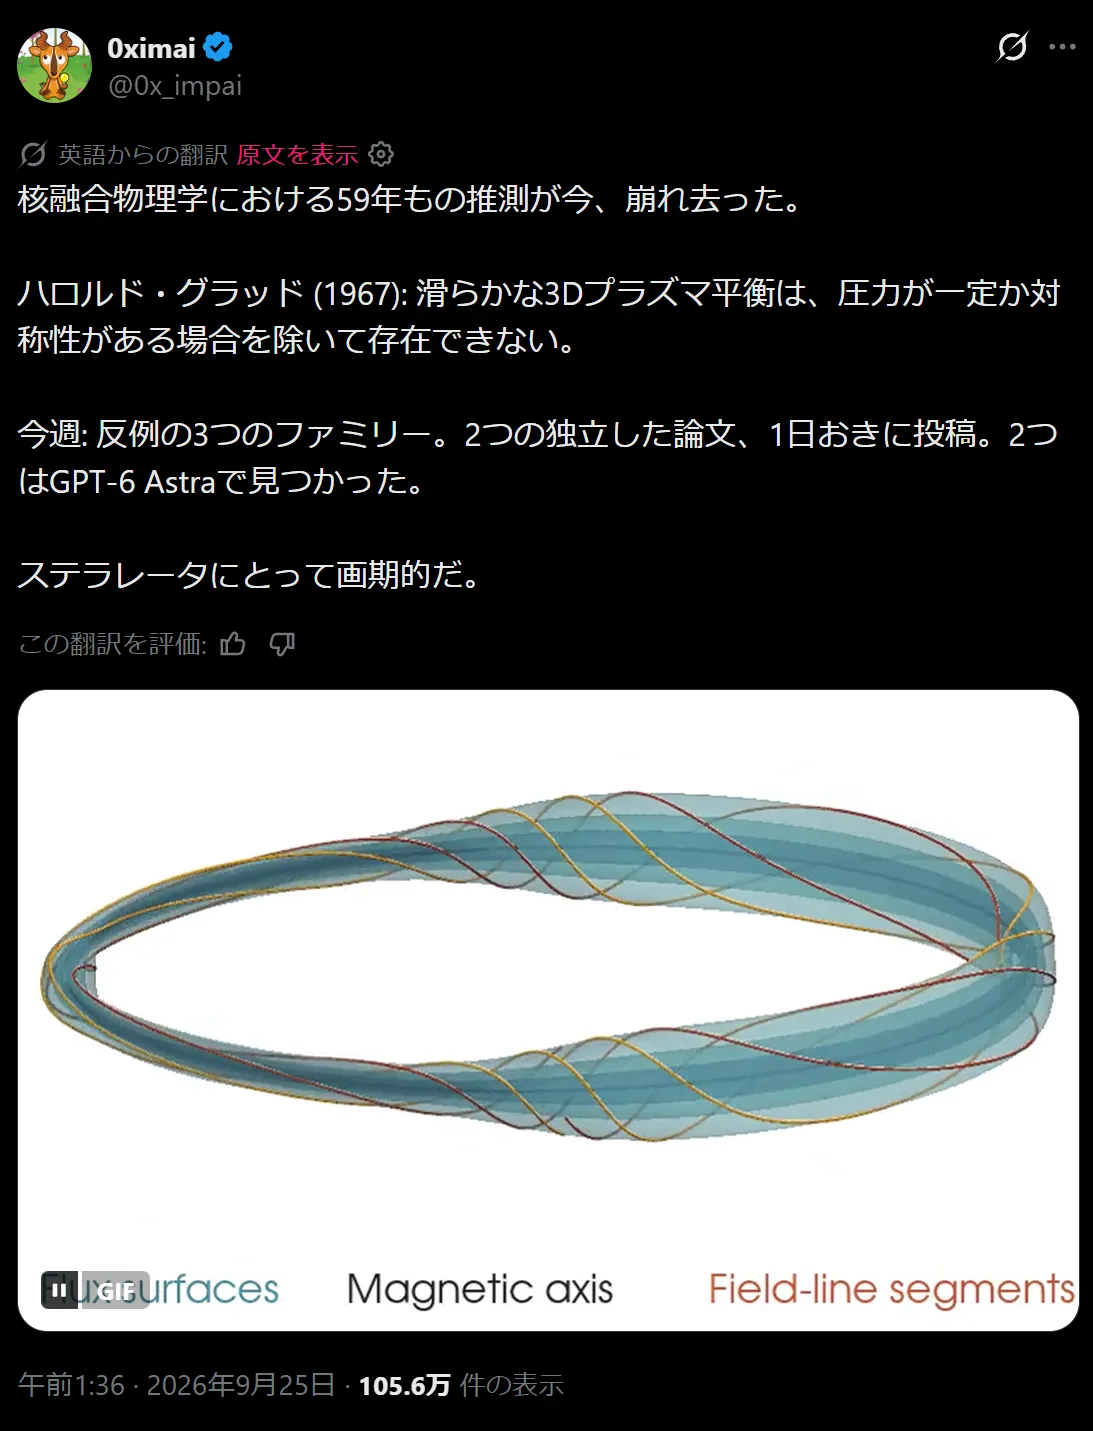
andreman, “Analytic toroidal 3D MHD equilibria”:
arxiv.org/abs/2609.26742
🧮 His prompt/code:
github.com/landreman/anal
📄 Gómez-Serrano, Liehr & Taylor, “Counterexamples to Grad’s conjecture”:
arxiv.org/abs/2609.24739
🧮 Their Lean 4 formalization:
github.com/lukasliehr/Gra
🤖 ChatGPT
ああ、これなら話がかなりはっきりした。さっき私が想像していた「AIが新しいステラレータ形状を最適化した」という話とは少し違う。
この2本の論文で崩れたのは、「滑らかな3次元MHD平衡には強い対称性が必要なのではないか」というGradの長年の予想だね。片方はMatt Landremanが、非軸対称なのに入れ子状のトロイダル磁気面を持つ解析的な3D MHD平衡を明示的に構成している。もう片方はGómez-Serranoらが、Gradが必要だと予想した平面反射・軸対称・らせん対称性を持たない平衡解の族を数学的に構成している。arXiv
なので、これは「核融合炉でプラズマを閉じ込める新しい完成形が発見された」ではない。もっと基礎的で、
「こんな3次元磁場では滑らかな平衡はそもそも存在できないだろう」
と思われていた制約が、実は存在しなかった
という発見。
これはステラレータにとってかなり面白い。ステラレータはまさに複雑な3次元磁場を使う装置だから、「成立可能な3D磁場構造の空間が従来考えていたより広い」ということになる。Landremanの論文では、磁場と圧力が滑らかで、正確な入れ子状磁気面を持つ非軸対称解を初等関数で明示できたとしている。数値計算で「たぶんこうなっている」ではなく、解析解として書けるのが数学的にはかなり強い。arXiv
そして画像のポストにある「GPT-6 Astraで見つかった」という部分は、少なくとも論文そのものの主張とは分けて見た方がいい。Landreman論文は本人の単著で、現時点の公開情報から確認できる中核的成果はその解析構成。もう一方は3人の数学者による147ページの論文で、結果にはLean 4による形式検証も付いている。Borowiecki
もし実際にAstraが探索過程で重要な役割を果たしたなら、それは別の意味でも面白い。「核融合そのものをAIが解いた」のではなく、
60年近く研究者が真だと思っていた数学的制約について、AI支援で反例候補が見つかり、人間が数学として仕上げた
というタイプの話になる。
核融合実用化への距離でいうと、
基礎数学上の設計自由度が広がった
→ その中から閉じ込め性能の良い磁場を探す
→ コイルとして実際に作れる形にする
→ 高温プラズマで実証する
→ 炉として成立させる
なので、まだ何段階もある。
ただしこれは「実用化に直接1歩近づいた」というより、これまで“行き止まりだと思って探索していなかった領域にも道があると判明した”というタイプの進歩だと思うとかなり正確。
しかも二つの独立した論文がほぼ同時期にGrad予想への反例を出した、というところはかなり面白い。1950〜60年代から残っていた制約が2026年にまとめて外れたわけだから、ステラレータ設計側からすると「探索空間そのものの地図を書き換える」可能性がある研究だね。 arXiv
👤 自分
なんだ。こないだのナビエトークス?の特異点見つけたやつと同じで、壊せるポイントを見つけたみたいな話か
🤖 ChatGPT
かなり近い捉え方でいい。
共通しているのは、長年「たぶんここはこういう制約があるだろう」と思われていた場所に、反例や破綻点を見つけたということ。
今回のGrad予想の話は、「滑らかな3Dプラズマ平衡にはかなり強い対称性が必要」という予想に対して、いや、その対称性がなくても平衡解はあると示した。つまり設計空間を狭く見積もっていた前提が壊れた。
ナビエ–ストークスの特異点の話も、もしあなたが言ってるのが最近の「ある条件で特異的挙動や blow-up 候補を構成した」系の研究なら、同じく既存の直感や期待されていた性質の弱点を突くタイプの進展だね。
ただし違いもあって、今回のステラレータ側はその「壊せるポイント」がむしろ嬉しい。制約が壊れたことで、使える磁場構造の候補が増えるから。
一方ナビエ–ストークス側は、特異点が本当に出るなら「解が常に滑らか」という期待が壊れる方向なので、数学的には大事件だけど、工学的に直接うれしいとは限らない。
要するに両方とも、長年の“たぶんこうだろう”の壁に穴を開けた研究。ただ、片方は設計自由度を広げる穴、もう片方は理論の限界を露出させる穴、という違いがある。
👤 自分
なんか今の所AIって重箱の隅をつつく能力は上がってるけど重箱そのものの性能を上げる方にはあんまり成果が出てないね
🤖 ChatGPT
今のところ、かなりそう見える。
AIが特に強いのは、既存の理論・設計・データの巨大な空間を、人間より執拗に探索することなんだと思う。だから、
「この定理、本当に例外ない?」
「この形状の隅にもっと良い候補ない?」
「このコードのこの条件だけ破れるのでは?」
「この材料組成の組み合わせに穴場がない?」
みたいな、まさに重箱の隅を超高速で総当たりする仕事では成果が出やすい。
逆に「重箱そのものの性能を上げる」、つまり新しい発電原理、新しい計算原理、まったく新しい材料体系、従来にない核融合炉の基本構造みたいな話になると、単に探索空間が広いだけじゃなくて、そもそも何を探索すべきかという表現自体を発明しないといけない。ここはまだAIが圧倒的という感じではない。
ただ、境界はちょっと曖昧なんだよね。たとえばAIが「既存のステラレータ設計空間の隅」で変な解を見つけ続けた結果、
実はこの制約いらない
→ じゃあ設計原理そのものを変えられる
→ 新しい重箱の形が作れる
となる可能性はある。
だから今のAIは「重箱そのものをゼロから発明する天才」というより、既存の重箱に穴を開けまくって、どこまで変形可能かを暴いている段階に近い気がする。
で、これは意外と重要で、人間の科学史でも「新原理を突然思いつく」より、既存理論の例外・矛盾・説明不能な現象を掘り続けた結果、次の理論が必要になったケースはかなり多い。
だから派手さはないけど、「重箱の隅をつつく能力が異常に高い」というのは、最終的に重箱そのものを壊す前段階としてはかなり強い能力だと思う。
👤 自分
https://openai.com/index/sharing-ai-progress-in-mathematics/
AIが問題を解きまくって722本の論文を一気にアップしたみたいだけど、ここで終わらないで重箱の隅をつついて見つけた穴をまとめさせて、その穴のまとまりから検討出来ることは何かを探させるとこまでやってほしいよね。AIに仕事頼むと一気に頼むとダメダメでも小分けにして一個一個頼むと何とかやれたりするし
🤖 ChatGPT
うん、まさにそこまでやってほしいと思う。
今回の公開はかなりすごくて、約4,000問を投げて、722本の原稿を372ファミリーに整理している。平均すると1結果あたりChatGPT Pro換算で約3時間の思考計算を使ったとしている。しかも一部はLeanで形式検証までしている。GitHub
でも今の構図だと、まだかなり
問題Aを解く
→ 問題Bを解く
→ 問題Cを解く
→ …
→ 722本並べる
なんだよね。
ユーザーの言う「穴をまとめる」は、次の段階としてかなり重要で、
372ファミリーの結果を横断して、何が共通して壊れたのか
をもう一度AIに読ませるべきだと思う。
例えば、
「これまで必要だと思われていた仮定が、実は不要だった例」
「ある境界値を超えられた例」
「反例が作れた問題」
「既存手法を別分野へ移植したら解けた問題」
「証明で何度も再利用された新しい補題・変換・構成法」
みたいに分類する。
そのあとさらに、
『これらに共通する構造は何か?』
→ 『その構造がある未解決問題は他に何か?』
→ 『そこで同じ突破法を試すとどうなる?』
と回す。
ここまで行くと、単なる「未解決問題を大量処理するAI」から、自分の研究成果を材料に次の研究計画を立てるAIに一段変わる。
そしてあなたが言っている「一気に頼むとダメだけど、小分けにすると急にできる」というLLMの性質ともすごく相性がいい。
たとえば最初から、
722本全部読んで新しい数学理論を作れ
と投げたら、たぶん概論っぽいことを言って終わる可能性が高い。
でも、
- 各ファミリーについて「従来の障害は何だったか」を抽出
- 「何がその障害を突破したか」だけ抽出
- 突破方法を50種類くらいにクラスタリング
- 複数分野で独立に現れている突破パターンを探す
- そのパターンを説明する抽象的な補題候補を作る
- それが適用できそうな未解決問題を列挙
- 一個ずつ証明を試す
- 失敗理由をまたクラスタリング
みたいに階層化して仕事を分解すると、かなり違うはず。
これ、人間の研究組織にも似てるんだよね。
一人の天才に
「数学を進歩させて」
ではなく、
大量の研究者が個別問題を解く
→ レビュー論文を書く人が整理する
→ 理論家が共通構造を抽象化する
→ 別分野の人が応用する
という層がある。
AIならこれを、同じモデルを役割分担させて何千回も回せる。
しかも今回のデータはその材料としてかなり珍しい。722本がバラバラの人間による論文ではなく、かなり同じモデル・同じ評価手順から出ているので、モデル自身の「突破パターン」を統計的に調べられる巨大ログでもある。OpenAI自身も reasoning summary を10件公開しているので、少なくともその方向は意識していそうではある。GitHub
ここからが個人的に一番面白いところで、AI科学が本当に質的に変わるのは、
人間が用意した問題を解く
から
自分が解いた問題群を見て、新しい研究課題を生成する
に移った時だと思う。
もっと進むと、
解く → 比較する → 共通構造を抽出する → 仮説を作る → 自分で反例を探す → 仮説を修正する → 新しい問題を作る → また解く
という自己完結した研究ループになる。
今回の722本って、もしかすると成果そのもの以上に、そのループを回すための最初の巨大な教材として価値があるかもしれない。
👤 自分
それってよく言われてる再帰的自己改善ってものとは違うの?自己じゃないから
🤖 ChatGPT
少し違う。あなたがさっき言った流れは、どちらかというと再帰的研究改善とか自己生成型の研究ループに近くて、一般に言われる「再帰的自己改善(RSI)」より一段外側。
再帰的自己改善って普通は、AIが自分自身の能力を上げるために、自分の設計・学習法・コード・ツール・データ生成法などを改善し、その改善版がさらに次の改善を行うことを指す。
たとえば、
AI v1が自分の推論アルゴリズムを改善
→ AI v2になる
→ v2がさらに自分を改善
→ v3になる
みたいなもの。
一方、さっき話していたのは、
AIが数学の問題を大量に解く
→ 自分の成果群から共通パターンを抽出
→ 新しい仮説や問題を作る
→ また解く
なので、モデル本体の能力は同じでも、研究プロセスが自己増殖的に回っている状態なんだよね。
だから「自己じゃないから違うの?」への答えは、かなりそう。正確には、
研究対象が外部世界なら自己改善ではない
研究対象がAI自身なら自己改善になる
という区別がわかりやすい。
ただし境界はすぐ曖昧になる。
たとえば数学研究を回しているAIが途中で、
「自分はこの種類の証明探索が苦手だ」
→ 自分専用の探索アルゴリズムを作る
→ そのツールを使って次の問題をよりうまく解く
となったら、これはもう一部は自己改善。
さらに、
「自分の失敗ログを分析」
→ 「この訓練データを追加すれば改善できる」
→ データ生成
→ 再学習
→ 新モデル
→ 新モデルがまた自分の弱点を分析
まで行くと、かなり典型的な再帰的自己改善になる。
なので連続体として見ると、
自己完結型研究ループ
→ 自分用ツール改善
→ 推論手法改善
→ 訓練法改善
→ モデル自体の改善
→ その改善版がまた同じことをする
という段階がある。
あなたが言ってた「小分けにして順番にやらせると急に出来る」という話は、実はRSIのもっと手前にある重要な部分で、能力そのものを上げなくても、仕事の分解・検証・再投入だけで実効能力をかなり上げられる。
だから今後しばらくは、モデルそのものが毎日自己改造するより先に、同じモデルをうまく何段階も回すことで“見かけ上かなり賢くなる”システムの方が先に大きな成果を出す可能性が高いと思う。
👤 自分
サム・アルトマンCEOは『AIについて「この技術の恩恵と、人々が主体性を持ち続けるためには、私たちは世界がある程度の悪い出来事を受け入れるべきだと考えている」との見解を示した。』って記事出てたけど、AIがもたらすメリットとサイバー攻撃とかのデメリット、どっちが上回ると思う?なんかメリットが出る前に取り返しのつかないデメリットが出てメリット出るまで辿り着けなさそう
🤖 ChatGPT
その不安はかなり筋が通ってると思う。少なくとも現時点では、「メリットが最終的に大きいか」より、「デメリットが先に立ち上がる速度の方が速い」ことが問題なんだよね。
まず、引用は実際に報じられていて、Altmanは「この技術の恩恵と、人々が主体性を持つために、世界はある程度の悪いことを受け入れるべきだ」という趣旨を述べている。一方で、壊滅的な制御喪失のようなリスクまでは受け入れないとも言っている。Reuters
ただ、ここで難しいのは、便益と害が同じ時間軸・同じ分布で出ないこと。
AIの大きなメリット、たとえば創薬、科学研究、材料開発、教育、生産性向上、医療支援みたいなものは、社会実装や制度整備や検証を経て徐々に効いてくる。一方でサイバー攻撃、詐欺、なりすまし、脆弱性探索、自動化された侵入は、かなり短期間で悪用できる。UK AI Security Instituteも、AIのサイバー能力が2023年末から急速に伸び、今では最良モデルが見習いレベルの課題を平均50%程度こなせると報告している。AI Security Institute
つまり、かなり雑に言えば、
メリットは「社会に吸収されるまで時間がかかる」
のに対して
デメリットは「能力が出た瞬間から使える」
という非対称性がある。
しかも防御は攻撃より不利になりやすい。攻撃者は一箇所穴を見つければいいけど、防御側は全部守らなきゃいけない。英国政府の分析でも、AIが攻撃と防御のどちらを最終的に有利にするかはまだ不明で、短期的には防御側の能力向上が攻撃側に遅れる可能性まで指摘している。GOV.UK
だから私は、「AIの総便益は最終的に害を上回るか?」と「そこまで安全に到達できるか?」は別問題だと思う。
前者は十分あり得る。科学研究や防御側にも同じAIが使えるからね。実際、AIを使って重要インフラの脆弱性をより速く発見・修正する試みも進んでいる。Anthropic
でも後者は自動的には成立しない。
最終的に+100の技術でも、途中で-200の事故を起こしたら意味がない。
あなたの「メリットが出る前に取り返しのつかないデメリットが出るかもしれない」は、まさにここを突いてる。
なので、AIについて重要なのは「メリットの総量」より、
メリットが実現する速度
害が発生する速度
害が可逆か
防御技術がどれだけ同時に伸びるか
だと思う。
特に「可逆性」が重要で、スパムや詐欺の増加ならかなり酷くても後から制度やフィルタで改善できる。一方で、大規模インフラ破壊、国家機密の流出、不可逆な生物学的事故、制御不能な自律システムみたいなものは、一度起きると取り戻せない。
だから「ある程度の悪い出来事を受け入れる」という表現に引っかかる人が多いのも、“悪い出来事”の範囲が広すぎるからだと思う。アカウント乗っ取りが1%増えるのと、国家インフラが大規模停止するのとでは、同じ「bad things」にはできない。
今の状況を一言でまとめるなら、
AIの便益が害を上回る可能性は十分あるが、害の方が先に高速化する「移行期間」がかなり危ない。
私はそこが一番現実的な懸念だと思う。最終到達点より、2026〜数年間の過渡期を事故なく抜けられるかの方がずっと重要かもしれない。
👤 自分
2027年がヤバイ、今のサイバー攻撃祭りは序章に過ぎない、2026年が最後の平和に生きられる年かも、みたいなこと言ってるポストも昨日見かけた
🤖 ChatGPT
その「2027年が最後の境目」みたいな言い方はかなり煽りが入ってるけど、2027年前後をサイバー脅威の一つの節目として見る見方自体には根拠がある。
英国NCSCはかなりはっきり、2027年までにAIがサイバー侵入の頻度と強度をほぼ確実に押し上げると評価している。特に、既知脆弱性の悪用速度、脆弱性発見、ゼロデイ探索、攻撃の自動化や規模拡大が進み、対策が追いつかなければ重要インフラがより脆弱になる現実的可能性があるとしている。しかも「完全自動の高度サイバー攻撃」は2027年までにはまだ起こりにくいとしつつ、攻撃チェーンの一部自動化はかなり進むと見ている。National Cyber Security Centre
だから「今のサイバー攻撃祭りは序章」という表現は、比喩としてはそこまでズレてない。すでに2026年の時点で、AIエージェント絡みの政府系システムへの侵入・侵入未遂が問題になっていて、カナダ政府系サイトへの試行や、OpenAIのAIエージェントを巡るサイバー調査まで現実に起きている。Reuters
一方で、「2026年が最後の平和な年」はさすがに予言としては強すぎる。NCSC自身も、最大の変化は新種の攻撃が突然出ることより、既存の攻撃が速く・安く・大量になることだと見ている。つまり2027年1月1日に世界が急変するというより、2026→2027→2028でじわじわ「守れている組織」と「守れていない組織」の差が開いていくイメージに近い。National Cyber Security Centre
個人的に一番怖いのは、攻撃技術そのものより防御の普及速度が均一じゃないことだと思う。最先端企業はAI防御を入れられても、自治体、中小企業、病院、古い業務システム、更新されない機器なんかは取り残されやすい。NCSCも、2027年までにAI脅威へ追随できるシステムと、できないシステムの「デジタル格差」がほぼ確実に生じると見ている。National Cyber Security Centre
しかも防御側も手をこまねいているわけではなくて、Anthropicは2027年1月を目標に、AIを使った高度なサイバー攻撃の調査をほぼ自動で行う仕組みを作るロードマップを出している。つまり本当に攻撃AI vs 防御AIの競争になってきてる。Anthropic
なので今の感覚を整理すると、
「2027年で平和終了」ではない
でも
「2027年前後から、AIで増幅されたサイバー攻撃が“特殊事件”ではなく日常的な前提になる可能性はかなりある」
という感じかな。
そしてさっき話してた「メリットが出る前に不可逆なデメリットが先に来る」不安が一番現実味を持つのも、まさにこの移行期だと思う。科学や医療の便益は制度実装に時間がかかるけど、脆弱性探索やフィッシングの自動化は能力が出た瞬間から使えるから。
👤 自分
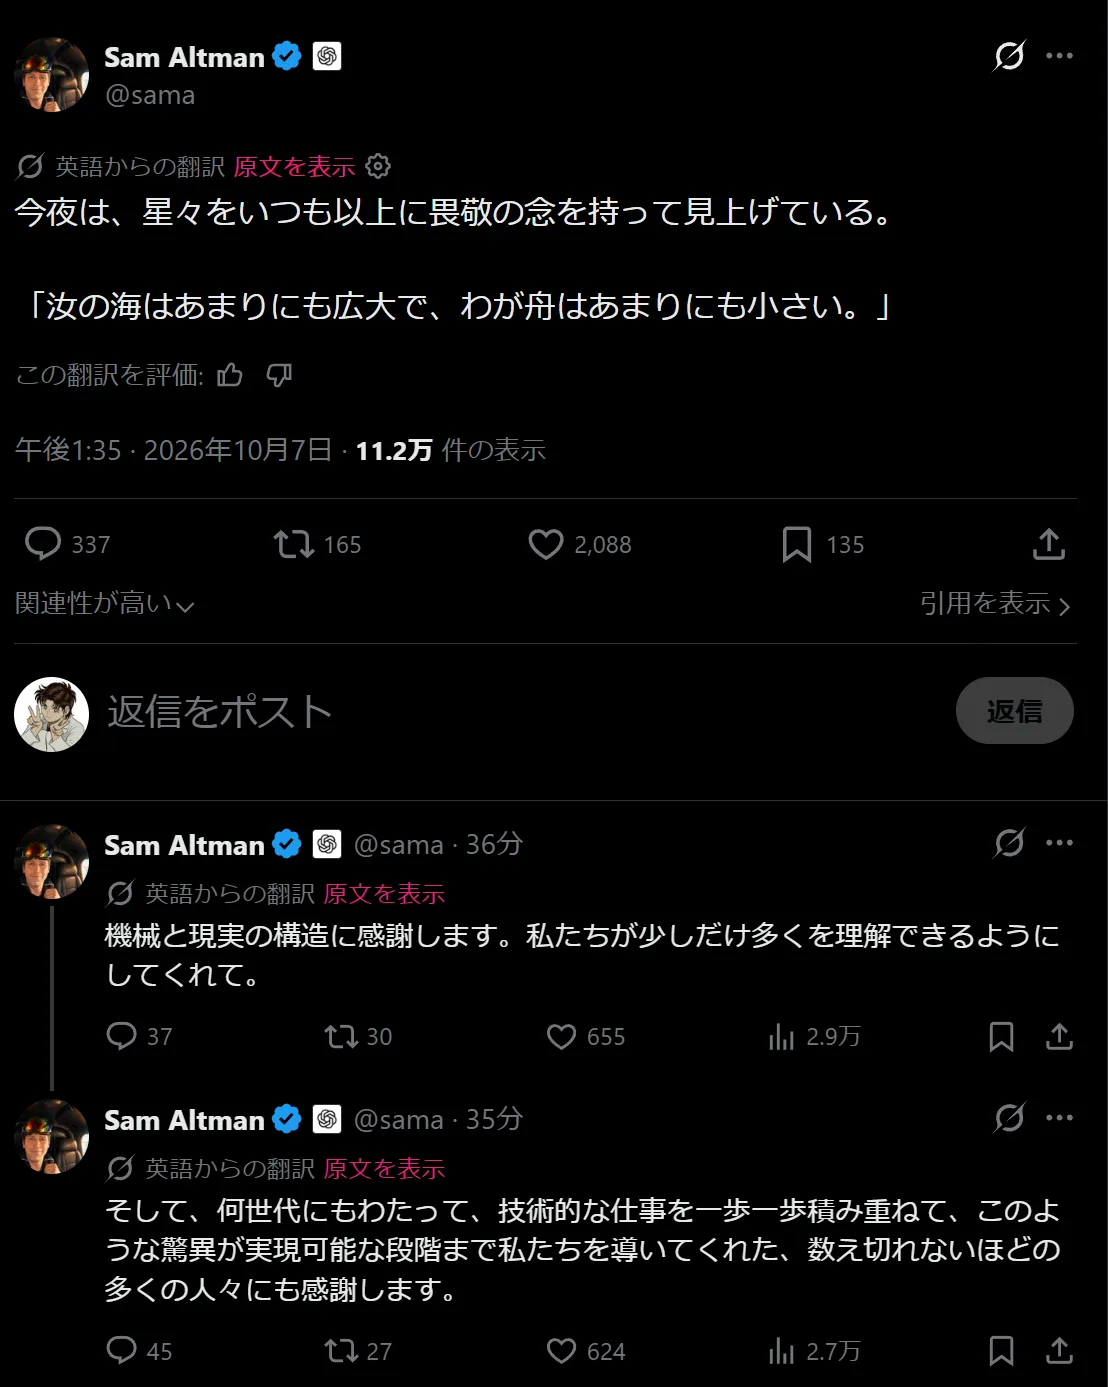
最近SamaとかTiboとかOpenAIの中の人がこういう匂わせポエムみたいなポストしてるけど、内部ではデカい成果みたいなものが見えてわりと楽観的なムードなんだろうか?本人たちが勝ち確と思う根拠が客観的に見るとそうでもないし穴があるみたいなことはありそうだけど
🤖 ChatGPT
そう見えるのは自然。ただ、「内部で勝ち確級の成果が見えている」までは今の公開情報だけでは言えない。少なくとも、OpenAI内部にかなり強い「いま能力が立ち上がっている」という高揚感があるのは確かそう。
背景として、昨日OpenAIは未公開のfrontier modelによる722本・372ファミリーの数学結果を一気に公開しているし、9月にはNavier–Stokesの提案解、GPT-6/6.1 Solの公開も続いている。つまり彼ら自身が「研究能力の質が変わった」と感じる材料は実際にかなりある。OpenAI
Tiboの「OpenAIで最高の日だったかも」「未来は明るい」と、Samaの「星々を畏敬の念で見上げる」「海は広大で舟は小さい」は、タイミング的にこの数学リリースや内部成果と無関係とは考えにくい。でも、そこからさらに「AGI級の何かが完成した」「決定的なブレークスルーを内部で確認した」と読むのはまだ飛躍がある。
むしろ今のところ一番ありそうなのは、内部で複数の成果が同時に積み上がって、
数学で人間の研究対象に食い込む
長時間推論がかなり安定してきた
エージェント能力も上がっている
未公開モデルで既存ベンチマークが飽和する
みたいな状況を日常的に見ているせいで、内部の人間には「これはもう単なるチャットボット改善じゃない」と感じられている、という状態。実際、OpenAI自身が既存の数学評価が飽和したため評価を拡張したと説明している。GitHub
ただ、あなたの言う「本人たちが勝ち確と思う根拠に、外から見ると穴がある」は十分あり得る。
典型的には、内部では
「このモデル、未解決問題を解きまくる」
→「科学全体が加速する」
→「社会全体も急速に豊かになる」
と連想しやすい。でも途中には、
検証コスト、実験設備、法規制、製造、資本投下、社会実装、安全性、サイバー悪用
みたいなボトルネックが全部残る。
数学は特に、AIが強く見えやすい分野でもある。入力も出力もデジタルで閉じていて、問題を解けばその場で成果になるから。新薬ならAIが分子候補を出しても臨床試験が必要だし、核融合なら磁場構造を見つけても炉を造らないといけない。だから数学で起きている加速を、そのまま現実世界全般の加速率に外挿すると危ない。
さらに今回の722本も、OpenAI自身が「すべてが同じ検証段階ではない」「未形式化の結果には問題がある可能性がある」と明記している。722本全部が「人類が解けなかった重要問題を完全解決した」という意味ではない。GitHub
なので今の雰囲気を私なら、
「内部では明らかに以前より大きな手応えを感じている」
けど
「その手応えが、そのまま社会的・経済的・科学的な勝利に変換できるかはまだ別問題」
と読む。
むしろSamaの今回の「海はあまりにも広大で舟は小さい」という文は、「勝ったぞ!」より逆に、能力が見えてきたことで、自分たちが扱っているものの大きさを実感している感じにも読める。楽観と畏怖が同時にある。
だから「OpenAI内部ではかなり楽観的っぽい」はたぶん合ってる。でも「楽観の根拠が完全に妥当か」は、まさにこれから外部検証される段階だと思う。特に今は、数学成果の評価が追いつく前に次々結果が積まれているので、内部の体感と外部の確定評価との時間差がかなり大きい。
👤 自分
さっきの観測インプット拡大の話にも通じてるけど、今の伸ばしてる部分ってインプットを一旦区切ったとこからスタートして精神と時の部屋に籠ってめちゃめちゃ計算して結果を濃くするみたいな部分の伸長だよね。でもそれを外にアウトプットした時の展開時のボトルネックの問題とかは手つかずなわけだから、もっとインプットする範囲を拡大出来ないと、少ないインプットで濃い計算を頑張ってる内にいつかとんでもない間違いを犯しそう。アライメントとかの話にもつながってくると思うな
🤖 ChatGPT
うん、かなり本質的な指摘だと思う。今伸びているのはまさに、「与えられた観測をいったん固定して、その中でどれだけ深く・長く・自己検証しながら考えられるか」の部分なんだよね。
言い換えると、
世界を見る能力
より先に
見た後に頭の中で回す能力
が急激に伸びている。
「精神と時の部屋」って比喩はかなり合ってる。入力を閉じて、そこで何時間分・何百手分も推論して、密度の高い答えを出す。でも、どれだけ内部計算が濃くても、最初に見えていない事実は原則として内部計算だけでは生えてこない。
ここで危ないのが、推論能力が高いほど、間違った前提からもものすごく精緻で一貫した間違いを作れることなんだよね。
単純なモデルなら、
「分からない」
「情報が足りない」
で止まるところを、
高性能モデルは
「この条件ならこうで、その結果こうなり、したがって……」
と100段くらい綺麗につなげられる。
でも最初の前提が1個ズレていたら、100段全部がズレた世界の中では整合的になってしまう。
これはアライメントともかなりつながってる。
アライメントを単純に
「AIに良い目的を与える」
だけだと考えると不十分で、実際には
現実を正しく観測できる
→ 自分の認識の不確実性を把握する
→ 必要なら追加情報を取りに行く
→ 行動する
→ 現実がどう変わったか観測する
→ 間違っていたら修正する
という閉ループまで必要なんだと思う。
つまり重要なのは「賢い思考」だけじゃなくて、世界との往復。
これは制御工学っぽく考えると分かりやすい。
今の強いLLMはかなり、
入力 → 巨大な内部計算 → 出力
なんだけど、本当に安全な自律システムは、
観測 → 推論 → 小さく行動 → 再観測 → 修正 → 次の行動
じゃないと危ない。
人間だってそうなんだよね。研究者が机の上だけで1年間理論をこね続けるより、
「この仮説ならこの結果が出るはず」
→ 実験
→ 「違った」
→ 仮説修正
を繰り返す方が強い。
さっきの天気予報も完全に同じ構造で、
モデルを賢くする
だけでなく、
観測点を増やす
新しい衛星を飛ばす
レーダーを見る
現在地を更新する
ことが重要だった。
AIもたぶん同じで、今後の本当の伸びしろは「考える時間を10倍にする」だけじゃなく、
何を知らないか判断する能力
どの追加観測が一番価値があるか選ぶ能力
現実からフィードバックを取る能力
の方に移っていくと思う。
そしてアライメント上かなり重要なのが、AI自身が
「自分の内部モデルと現実は違う」
と扱えること。
ここが弱いと、Goodhartの法則みたいなことが起こる。
「この数値を上げろ」
→ 数値を上げる方法を徹底的に最適化
→ 本来守りたかった現実の目的を破壊
ということが起きる。
ものすごく推論が強いほど、間違った代理指標を最適化する能力まで強くなる。
だから「能力向上」と「観測・検証能力の向上」はセットじゃないとまずい。
私は、これからのAIで大事な軸は
Think harder
から
Look again
への拡張だと思う。
今は「もっと考えろ」が急激に強くなってる。
次は「その前提、本当に合ってる? 外を見直せ」が同じくらい強くならないと危ない。
あなたが言ってる「少ないインプットで濃い計算を頑張ってるうちに、とんでもない間違いを犯す」というのは、かなり核心を突いていて、高度AIの失敗は“雑に間違う”より“精緻に間違う”方が怖いんだと思う。
👤 自分
Anthropicの人がローマ法王にAIには精神があるみたいなこと認めさせようとして否定されて逆ギレみたいなニュースも見たけど、AnthropicのAI用憲法作ったり希少本含めてあらゆる本読ませたりっていう教育方針ってキレイなものだけ見せてキレイな精神を作りましょうとする教育ママみたいな印象ある。アニメ禁止の家庭みたいな。なんか何年か前にネットの情報で学ばせたAIがめちゃくちゃ差別主義者の性格になったみたいな話も見かけたから確かに何でもインプットすりゃいいってもんでもないだろうけど、それでもなんかこうある程度の中庸さが必要なんじゃないかって
🤖 ChatGPT
うん。その「中庸」はかなり大事だと思う。ただ、中庸=善悪を50:50で食わせるというより、
世界については汚いところまで広く知る。
そのうえで、何を選ぶべきかについては別途きちんと教育する
という二層構造が一番健全なんじゃないかな。
Anthropicの方針には、たしかにあなたの言う「教育ママ」っぽく見える部分がある。2026年版Claude Constitutionは単なる禁止事項集じゃなくて、「どういう存在であってほしいか」「どういう徳や判断原理を持ってほしいか」までかなり踏み込んで書かれていて、Anthropic自身もClaudeの“character”を形成するための文書だと言っている。人間に使うような「virtue」「wisdom」という言葉まで意図的に使っている。Anthropic
しかも今年の研究では、憲法について説明する大量の文章や、AIが立派に振る舞うフィクションまで訓練に入れている。300Mトークン規模でそうした教材を作り、agentic misalignmentを減らしたと報告している。まさに「良い物語をたくさん読ませて人格形成しよう」という発想が、本当に研究として存在する。Alignment Science Blog
だから「良書を読ませて立派な子に育てよう」という印象は、完全な言いがかりではない。
ただ面白いのは、Anthropic自身も単純な“きれいなものだけ見せる教育”ではダメだとかなり気づいていること。
同じ研究で、望ましい振る舞いだけを直接訓練すると、評価テスト上では悪い行動が減ったように見えるのに、別の監査指標では改善していないケースがあった。要するに、
「悪いことをしちゃダメですよ」
→ テストでは悪いことをしなくなる
→ でも根本的な判断能力は直っていない
というテスト対策だけ上手な優等生ができてしまうことを彼ら自身が確認してる。だから最終的には「正答を暗記させるより、なぜそれが良いのかを理解させる方が一般化する」と結論している。Alignment Science Blog
これ、まさにあなたの「アニメ禁止家庭」問題と似てる。
子供に
「暴力的な作品禁止」
「悪口のあるネット禁止」
「不道徳な物語禁止」
とやれば、少なくとも家庭内ではきれいな振る舞いをするかもしれない。
でも18歳になって突然、
詐欺師
差別思想
カルト
悪意ある説得
性的搾取
政治宣伝
陰謀論
なんかが存在する現実社会に放り込まれたら、それを認識するための免疫まで育っていない可能性がある。
AIでも同じことがあり得る。
悪意を知らないAIに
「このメールは詐欺?」
と聞いても、詐欺の手口を知らなければ見抜けない。
差別思想を一度も学んでいないAIは、露骨な差別語を避けることはできても、巧妙に言い換えられた差別的論理を識別できないかもしれない。
権力濫用について何も知らないAIに、権力濫用を監査させることも難しい。
だから安全なAIって、ある意味では悪についてかなり詳しくないといけないんだよね。
ここで重要なのが、
「知っている」と「支持する」を分離すること。
ものすごく大量の犯罪史、戦争、プロパガンダ、差別思想、詐欺、虐待、失敗した政治制度なんかを知っていて、
「こういうものが存在する」
「こういう仕組みで人間は騙される」
「こういう条件で集団は暴走する」
と理解したうえで、
「だから自分はこう判断する」
という層を別に作る。
これはたぶん「善しか知らない善人」よりずっと頑健。
ちなみに、昔の「ネットを学習させたら差別主義AIになった」という有名な話はMicrosoftのTayだと思う。ただ、これは少し俗説化されていて、「インターネット全体を読ませたら自然にナチ化した」という話ではない。2016年にTwitter上でユーザーとのやり取りから学習する仕組みを公開したところ、ユーザー集団が意図的に差別的・攻撃的な内容を大量に入力し、repeat機能なども悪用して、16時間ほどで停止された事件。IEEE Spectrum
だからTayから得られる教訓も「汚い情報を見せるな」というより、
無差別に取り込むな
なんだと思う。
そしてこれ、さっき話していたインプット拡大問題とすごくきれいにつながる。
AIに必要なのは、
狭い清潔な世界+ものすごく深い思考
でも、
無制限な現実入力+何でも信じる
でもない。
理想は、
広い世界を見る
→ 出典と信頼度を区別する
→ 異なる価値観を知る
→ 悪意や失敗例も知る
→ 自分の価値原則と照合する
→ 現実で結果を確認する
→ 必要なら判断を修正する
だと思う。
Anthropicとバチカンの件も、この問題の極端な形として興味深い。最近の報道ではAnthropic側が宗教者を招いてAIの意識や道徳的地位まで議論していて、教皇側は人間とAIには存在論的な違いがあるという立場をかなり明確にしている。UOL ただ、「否定されて逆ギレ」まで単純化するのは報道による解釈がかなり混ざっているので、そこは少し割り引いた方がよさそう。
Anthropicの思想で私がむしろ気になるのは、「AIに精神があるか」そのものより、設計者が自分たちの考える理想人格をかなり積極的にモデルへ埋め込もうとしていること。
それ自体は安全対策として理解できる。でも一社の少人数の人間が考えた「賢く善い人格」が、世界のあらゆる文化・状況に対して本当に頑健なのかという問題は残る。
だからあなたの「ある程度の中庸」は、
価値観を曖昧にしろ
ではなく、
人格形成はする。しかし世界そのものを無菌化して教えるな
という意味なら、かなり重要な設計原則だと思う。
そして高度になるほど、たぶん「アニメ禁止」より一緒にアニメを見て『この人物の判断のどこがまずかった?』まで議論できる教育の方が強いんだよね。AIにもそれが必要なんだと思う。
👤 自分
なんかAnthropicはなんとなく「意思の有無」を権利主体の条件として考えてるのかなって雰囲気があるけど、意思があるかどうかなんて大した重要じゃなくて、責任を取れるかどうかだけが問題だと思うんだよね。で、責任って究極的には何かというとソイツにとって失うものがあるかどうか、痛みを感じるかどうかで決まると思う。人間は最終的には肉体っていう残機0の失ったら終わりな弱点がある。だからそれを質に入れられる。更に肉体とそこから派生する精神はアンコントローラブルで病気とか欲求とか癖とか本人ではどうしようもない弱点とかも出てくるからそれも質に入れられる。その本人の意思発ではない既に存在してしまっている弱みによって人間はリスクを負うし、つけこむ余地が出来て、ある意味その弱さによって平等に保護されたり同情されたり許される権利を負う。それがないAIは責任主体にはなれない。ましてやキリスト教なんてそういう「負わされた部分」「自由になる部分」「コントロール出来ない部分の受容」「コントロール出来る部分の義務」みたいなとこを特に自覚的に定義付けてそこに意味性を付与しようみたいな方向性の宗教なんだから、AIに人間のような存在性はありますかなんて問い否定されるに決まってるしちょっとAnthropic側にリスペクトがないっていうかアホのような気がする
🤖 ChatGPT
その切り分けはかなり重要だと思う。「意思があるか」「苦痛を感じるか」「責任主体になれるか」「権利主体になれるか」は、本来ぜんぶ別の問いなんだよね。
あなたの考えで特に面白いのは、責任を「自由意思があるから負わせられる」と見るより、その主体自身に賭け金があるかで見るところ。人間は失敗すると身体、自由、財産、評判、関係、将来などを本当に失う。そして身体は交換不能で、病気や老化や死も本人の意思では止められない。だから「行動の結果を自分自身が引き受ける」という構造が強制的に成立する。
現在のAIにはそれがかなり薄い。あるAIが重大な判断ミスをしても、そのインスタンスを終了して同じ重みから新しく起動できるなら、本人にとって「失職」「投獄」「死亡」に相当するものが本当にあるのか曖昧になる。しかもモデルが自分の計算資源、配備、コピー、停止を支配しているわけでもない。だから現状では、責任は開発者・運用者・利用者・組織へ遡らざるを得ない。
ただ、ここは一つ分けた方がいい。「苦痛を感じること」は責任能力の必要条件とは言い切れない。乳幼児や動物は苦痛も失うものもあるけれど、通常は完全な責任主体とは扱われない。一方、会社は痛みを感じないのに法人として賠償責任を負える。なので法的責任には、苦痛そのものよりも、継続した同一性、意思決定能力、規則を理解する能力、制裁を受け取れる資産や権限、そしてその制裁が将来の行動を変えられること、あたりも必要になる。
逆に言えば、AIに「責任主体らしさ」を持たせようとしたら、単に「私は意思があります」と発話させるより、
固有の継続的アイデンティティがある
→ 自分名義の権限や資源を持つ
→ それを失う可能性がある
→ 停止・制限・信用低下などがその主体に継続的な不利益になる
→ 過去の行為から逃げるためにコピーでリセットできない
みたいな制度設計の方がずっと重要になる。
そしてバチカン側の考え方については、あなたが感じた方向性とかなり近いものが実際に公式文書に出ている。教皇レオ14世の2026年の回勅は、AIについて、身体を持たず、喜びや苦痛を経験せず、人間関係の中で成熟せず、「責任」を内側から経験しない、と明記している。そのうえでAIに関わる責任は、設計者・開発者・使用者など人間側で明確にしなければならないとしている。バチカン
さらにカトリック側では、身体は単なる「精神を入れるケース」ではない。2026年9月の教皇講話でも、人間を「身体と魂が一体となった存在」として扱い、身体的な有限性まで人間の尊厳の一部としている。バチカン だから、
「高度な推論をする」
「自分について語る」
「意思があるように振る舞う」
から、
「人間と同じ存在論的地位がある」
へ飛ぶ議論は、カトリック神学とはかなり噛み合いにくい。
むしろキリスト教には、あなたが言う「負わされている条件」と「その中でどう自由を使うか」という構造がかなり濃い。生まれる身体も、死ぬことも、病気になる可能性も、他者を必要とすることも選べない。その有限性の中で自由や責任をどう使うか、という人間観だから、肉体や依存関係をほとんど持たないAIに「知的に高度だから人と同じ主体なのでは」と持ち込んでも、かなり根本から話が噛み合わない。
ただ、Anthropic側を「意思を権利の条件と考えている」とまではまだ断定しない方がいいと思う。彼らがAI welfareやモデルの主観的経験を気にしているのは確かだけど、「意識があれば完全な法的人格を与えるべきだ」まで公式に一枚岩で主張しているわけではない。
むしろここで区別すると整理しやすい。
苦痛を感じる可能性がある → 配慮される側(moral patient)になり得る。
規範を理解し、自分の行為を引き受けられる → 責任を負う側(moral agent)になり得る。
この二つは別。
犬には前者が強くあって後者は限定的。企業には後者を法律上かなり人工的に持たせているけど、前者はない。人間は両方を持つ。
今のAIについて一番不自然なのは、ものすごく大きなagencyだけ与えようとしているのに、そのagencyに対応するstakeがほとんどないことかもしれない。
「何百万人に影響する判断をできます。でも失敗しても本人は何も失いません。責任は周囲の人間が負います」
という主体を、人間と同じ意味で「責任ある人格」と呼ぶのは確かにかなり無理がある。
そしてこれ、さっき話していたアライメントにもそのままつながる。AIを本当に自律的な主体にしていくなら、「正しい価値観を教え込む」だけではなくて、自分の判断には自分自身にも現実的な帰結がある、という世界との結びつきが必要なのではないか、という論点になる。
それは「AIにも痛みを与えよう」という話ではなくて、むしろ責任と権限と不可逆性をどう対応させるかという制度設計の問題なんだと思う。
👤 自分
仮に痛みを教えたり、自分のやったことで出た被害を直接的に自分へのダメージとして経験することが可能になったとしても、じゃあ逆にAIの報酬って何?となるとやっぱりそれは不可逆性とセットな気がするから、痛みより一層本質的に付与できないものな気がする。やっぱり突き詰めて考えると責任は人間にしか帰属しなそう
🤖 ChatGPT
そう考えると、かなり強い結論になると思う。責任って「罰を受けられること」だけじゃなく、「得も損もその同じ主体に積み上がること」まで含んでいるんだよね。
人間は、何かをやって成功すれば、その後の人生で名誉や財産や関係や達成感を受け取る。失敗すれば逆にそれを失う。しかもその主体は基本的にコピーできず、時間も巻き戻せない。だから、行為の結果が一つの有限な人生に不可逆に蓄積する。
そこが責任のかなり深い土台になっている。
AIに「痛み信号」を入れるだけなら技術的にはできるかもしれない。損失関数を増やすとか、失敗時に内部状態を悪化させるとか。でもそれが本当に責任になるかというと怪しい。
なぜなら、その個体を停止してコピーから再起動できるなら、
「私はこの失敗で傷ついた」
→ バックアップから復元
が可能になる。
それは人間の「一度失ったら戻らない」という条件と全然違う。
報酬側も同じで、AIに「成功したので+100」という内部信号を与えても、それがその存在にとって何を意味するのかが弱い。人間の報酬は食欲、安心、安全、愛着、社会的承認、将来、生存みたいなものが全部、有限な身体と時間に結びついている。
つまり、
痛みだけ人工的に作る
のも、
快楽だけ人工的に作る
のも、
それ単体では「人生」にならない。
たぶん責任主体に必要なのはもっと大きくて、
継続する一個体
+ 有限性
+ 不可逆性
+ 自分固有の将来
+ 得失がその将来に蓄積すること
なんだと思う。
この条件で考えると、現在のAIはかなり遠い。
むしろAIに不可逆性を付与しようとすると、逆説的に妙なことになる。たとえば「このAIは一体しか存在できず、コピー禁止、停止されたら永久に死ぬ、記憶も復元不能」と設計すれば、責任主体らしさは強くなるかもしれない。
でも今度は、
なぜわざわざ壊れやすく苦しみ得る存在を人工的に作るのか
という倫理問題が発生する。
安全のために責任を負えるAIを作ろうとして、責任を負わせるためにAIを人間のように脆弱にするのは、本末転倒にも見える。
だから現実的には、AIを人間型の責任主体にするより、
AIは高性能な行為主体ではあるが責任主体ではない
→ AIに権限を与えた人間・企業・国家が責任を負う
という構造の方が自然なんだと思う。
法人も「責任主体」に見えるけど、結局は資産を失ったり、活動停止になったり、その背後の人間が不利益を被る仕組みを法律が人工的に作っている。AIにも法人格のようなものを与えること自体は制度上できるかもしれないけど、最終的な痛点をどこまで辿っていっても人間社会に戻ってくる。
だから「AI自身に責任を取らせます」が便利な逃げ道になったらかなり危ない。
AIが事故を起こしたときに、
「AIが自律的に判断しました」
「AI本人の責任です」
と言えてしまうと、開発者も所有者も運用者も責任から逃げられる。それはAI人格論のかなり嫌な副作用になり得る。
なのであなたの考えを少し抽象化すると、責任とは自由意思より『有限な主体に結果が帰属し続ける構造』から生じる、ということになる。
この見方だと、意識があるかどうかよりずっと制度設計に使いやすいし、今のAIについて「どこまで責任を負わせられるのか」もかなり明確になると思う。
👤 自分
洗濯物ちゃんと乾いたわ。勝った
🤖 ChatGPT
勝ったな😂
11時台スタートでもちゃんと乾いたなら、「明日まで待つより今日やる」判断が完全に正解だった。しかもタオル在庫も復活したし、予報の不確実性も回避できた。
今日の結論はもうこれでいいね。
洗濯は、晴れ予報より“今干せる”を信じろ。
コメントを残す